
计算机图形学复习
OpenGL
GPU Pipeline
Programmable Shader
1、Geometry Shader 有什么作用?如何使用它实现 Billboard 算法?
2、Tessellation Shader 如何实现细分曲面?相比早期的 Bump map/Normal map,它有什么优势?是模型级别还是像素级别,乃至次像素级别?
3、GPU-Driven Pipeline 中为什么大量使用了 Compute Shader 以及 Mesh/Cull Shader?它们具体是怎么工作的?
Coordinate System
1、在 GPU Pipeline 中,输入顶点的坐标是如何发生变换的?每一步的作用是什么?变化前后的坐标范围分别是?
| 坐标空间 (Space) | 作用与物理意义 | 变换矩阵 / 操作 | 坐标范围 (Range) |
|---|---|---|---|
| Model Space(模型空间 / 局部空间) | 建模软件中物体本身的独立坐标系,原点 $ (0,0,0) $ 通常位于物体的几何中心或底部 | — | 任意实数 $ \mathbb{R}^3 $ (取决于建模尺寸) |
| World Space(世界空间) | 将所有独立模型放置到统一的全景 3D 场景坐标系中 | Model Matrix $ \mathbf{M} $ (平移 $ \mathbf{T} $ 、旋转 $ \mathbf{R} $ 、缩放 $ \mathbf{S} $ ) | 任意实数 $ \mathbb{R}^3 $ |
| View Space(相机空间 / 观察空间) | 以相机为坐标原点、观察方向为轴建立坐标系,方便后续进行视角剔除与裁剪 | View Matrix $ \mathbf{V} $ (相机的逆变换:先平移相机构造原点,再旋转轴向) | 任意实数 $ \mathbb{R}^3 $ (视锥体范围内 $ z \in [-N, -F] $ ,右手系下相机正前方为负 $ Z $ ) |
| Clip Space(裁剪空间) | 将观察锥体(视锥体 Frustum)挤压/变形为一个规则的立方体,为齐次坐标裁剪(Clipping)做准备 | Projection Matrix $ \mathbf{P} $ (透视投影矩阵或正交投影矩阵) | 齐次坐标系 $ (x_c, y_c, z_c, w_c) $ 范围满足 $ -w_c \le x_c, y_c, z_c \le w_c $ |
| NDC Space(归一化设备坐标) | 彻底摆脱齐次分量 $ w_c $ ,将空间标准化为设备无关的标准单位立方体(此时已完成硬件裁剪) | 透视除法 (Perspective Divide)(由 GPU 硬件自动执行: $ \mathbf{v}{ndc} = \frac{\mathbf{v}{clip}}{w_c} $ ) | OpenGL: $ [-1, 1]^3 $ Vulkan / DirectX: $ x,y \in [-1, 1], z \in [0, 1] $ |
| Screen Space(屏幕空间) | 将 2D 标准坐标与深度值映射到真实的像素网格(Viewport)上,交由光栅化器生成 Fragment | 视口变换 (Viewport Transform)(如 glViewport(x, y, w, h)) |
$ x \in [0, w] $ , $ y \in [0, h] $ $ z \in [0, 1] $ (写入 Depth Buffer) |
2、在模型的平移变换常由一个4x4矩阵表示,最后一维的作用是什么?
齐次矩阵是一个 $(n+1) \times (n+1)$ 的方阵,定义为在射影空间 $\mathbb{P}^n$ 上执行线性变换(Linear Transformation)的矩阵算子。
对于 3D 欧氏空间($n=3$),齐次矩阵 $\mathbf{M} \in \mathbb{R}^{4 \times 4}$ 拥有如下的分块矩阵(Block Matrix)通用结构:$$\mathbf{M} = \begin{bmatrix} \mathbf{R}{3 \times 3} & \mathbf{t}{3 \times 1} \ \mathbf{p}{1 \times 3}^T & w{1 \times 1} \end{bmatrix} = \begin{bmatrix} r_{11} & r_{12} & r_{13} & t_x \ r_{21} & r_{22} & r_{23} & t_y \ r_{31} & r_{32} & r_{33} & t_z \ p_x & p_y & p_z & w \end{bmatrix}$$$\mathbf{R}_{3 \times 3}$(线性变换子块):表达旋转、缩放、错切(Shear)等线性变换。
$\mathbf{t}{3 \times 1}$(平移子块):表达欧氏空间中的平移向量 $\mathbf{t} = (t_x, t_y, t_z)^T$。 $\mathbf{p}{1 \times 3}^T$(透视投影子块):表达透视收缩(Perspective Contraction),决定齐次除法分母的变化。 $w_{1 \times 1}$(全局缩放因子):通常保持为 $1.0$。
3、对于模型的选择变换而言,常见的表示方式包括:欧拉角和四元数。二者的转换关系是什么?
欧拉角就是物体绕坐标系三个坐标轴(x, y, z轴)的旋转角度,在这里坐标系可以是世界坐标系,也可以是物体坐标系,旋转顺序也是任意的。最常见的做法便是依次使用X、Y、Z三轴的旋转角度描述变换。
尽管欧拉角在具有简单直观的特点,但其局限性也很明确:
- 欧拉角受旋转顺序影响;
- 欧拉角存在万向锁问题(Gimbal Lock)。
其中,万向锁问题是指:当按某种顺序(如 XYZ 或 YXZ)旋转时,如果第二个旋转轴旋转了 $\pm 90^\circ$,会导致第三个旋转轴与第一个旋转轴重合。此时系统会丢失一个旋转自由度(3D 旋转退化为 2D 旋转),导致无论怎么改变剩下的角度都无法绕丢失的那个维度旋转。
4、为什么四元数能够表示一个旋转矩阵,它的实部和虚部的实际意义是什么?角轴又是什么?引入四元数的好处是?
角轴与四元数:
三维空间中的任意旋转,均可等价地描述为:绕某一特定单位轴 $\mathbf{u}$ 旋转一个指定的角度 $\theta$,这便是经典的角轴(Axis-Angle)表示法。
单位四元数之所以能够完美表示三维旋转,是因为它将“旋转轴”与“旋转角”巧妙地编码进了一个四维超球面上的单位向量中。
一个标准的单位四元数可写作:$$q = w + xi + yj + zk = \cos\frac{\theta}{2} + \mathbf{u} \sin\frac{\theta}{2}$$
其中,实部 $\cos\frac{\theta}{2}$ 编码了旋转角度的一半,而虚部 $\mathbf{u} \sin\frac{\theta}{2}$ 则决定了旋转的方向。
罗德里格斯公式:
当你已知旋转轴 $\mathbf{u}$ 和旋转角 $\theta$ 时,罗德里格斯公式给出的旋转后向量 $\mathbf{v}'$ 的计算公式为:
$$\mathbf{v}' = \mathbf{v}\cos\theta + (\mathbf{u} \times \mathbf{v})\sin\theta + \mathbf{u}(\mathbf{u} \cdot \mathbf{v})(1 - \cos\theta)$$
如果把这个公式写成矩阵形式(即罗德里格斯旋转矩阵 $R$),它长这样:$$R = I + \sin\theta K + (1 - \cos\theta)K^2$$其中 $I$ 是 $3 \times 3$ 单位矩阵,$K$ 是旋转轴 $\mathbf{u} = (u_x, u_y, u_z)$ 构成的反对称矩阵:
$$K = \begin{bmatrix} 0 & -u_z & u_y \ u_z & 0 & -u_x \ -u_y & u_x & 0 \end{bmatrix}$$
三维旋转与四元数:
在二维平面上,一个点 $(x, y)$ 可以写成复数 $z = x + iy$。如果我们想让这个复数逆时针旋转一个角度 $\theta$,只需要乘以一个模长为 1 的复数,即可实现旋转:
$$e^{i\theta} = \cos\theta + i\sin\theta$$
当数学家尝试将这一优美的复数旋转机制扩展至三维空间时,直觉上会认为:既然 2D 旋转需要 2 个分量,那么 3D 旋转理应需要 3 个分量,也即形如 $a + bi + cj$ 的“三元数”。然而,在实际验证时,该假设却遭遇了不可逾越的代数障碍:
- 代数无法闭合:若定义 $i^2 = -1$ 且 $j^2 = -1$,两者的乘积 $ij$ 将无处安放。若强制令 $ij = k$,为了维持代数系统的自洽性,系统便被迫引入了第四个维度。
- 弗罗贝尼乌斯定理:在实数域上,能够构成“赋范除环”(即支持常规加减乘除、且满足乘法模长恒等式 $\vert{}ab\vert{} = \vert{}a\vert{}\vert{}b\vert{}$)的超复数系统仅有三种——实数(1D)、复数(2D)和四元数(4D)。这意味着三元数这种代数结构在数学上根本不存在。
当我们试图在实数基础上构建一个既能做除法、又能无奇点表达空间旋转的代数体系时,数学规律直接将我们从 3 维“跳过”,推向了 4 维的四元数世界。
四元数表示旋转的优势:
总体而言,使用四元数表示旋转的好处包括:
- 解决了万向锁的问题:
- 计算效率高与内存紧凑:存储一个旋转只需 4 个浮点数(相比 3x3 矩阵的 9 个数更省内存),且连续多次旋转的复合时仅需四元数相乘,比矩阵相乘需要的计算量更小。
- 支持平滑插值(SLERP):在做骨骼动画、相机平滑过渡时,欧拉角插值会出现畸变或非匀速运动,而四元数支持 SLERP(球面线性插值),能够在四维单位球面上以最短路径、匀速地过渡两个旋转状态。
5、相机的视图矩阵本质是什么?对于glm::lookAt函数,需要传入什么参数?
相机的视图矩阵本质是一个平移和旋转矩阵的组合。毕竟,从世界坐标系到相机坐标系,需要先将原点平移到相机位置,再按相机指向旋转到指定方向。
glm::mat4 view = glm::lookAt(eye, center, up);
6、详细说明一下相机的投影矩阵推导过程,尤其是其中z坐标值在投影前后的对应关系,以及w坐标值的作用。
在计算机图形学中,投影矩阵(Projection Matrix)的核心使命是:将相机空间(View Space / Eye Space)中的三维几何体,经过空间压扁和规范化,投射到标准的裁剪空间(Clip Space)或归一化设备空间(NDC Space),为后续的透视除法和光栅化做准备。
以正交投影为例,它的视景体(Frustum)是一个长方体,由左右 $[l, r]$、上下 $[b, t]$、以及近远平面 $[n, f]$ 定义。要把这个长方体变换到 NDC 的立方体 $[-1, 1]^3$ 中,只需要两步:
- 平移(Translation):把视景体的中心平移到坐标系原点 $(0, 0, 0)$。中心点坐标为 $\left(\frac{r+l}{2}, \frac{t+b}{2}, \frac{-n-f}{2}\right)$。
- 缩放(Scaling):把长方体的长、宽、高分别缩放到长度为 2。缩放系数为 $\frac{2}{r-l}$、$\frac{2}{t-b}$、$\frac{2}{n-f}$。
因此,最终合成的正交投影矩阵为:$$P_{ortho} = \begin{bmatrix} \frac{2}{r-l} & 0 & 0 & -\frac{r+l}{r-l} \ 0 & \frac{2}{t-b} & 0 & -\frac{t+b}{t-b} \ 0 & 0 & \frac{-2}{f-n} & -\frac{f+n}{f-n} \ 0 & 0 & 0 & 1 \end{bmatrix}$$可以看出,正交投影是完全线性的,矩阵的最后一行是 [0, 0, 0, 1],这意味着 $w$ 始终保持为 $1$,变换前后没有发生任何非线性畸变。
相比之下,透射投影的视景体是一个平截头体(Frustum)——近大远小,远平面的截面积远大于近平面。直接用线性矩阵无法将截头体变成正方体,必须引入非线性压缩。
具体而言,该投影矩阵需要将旋转后的w分量变成-z,其数学表达式如下:
$$P_{\text{persp}} = \begin{bmatrix} \frac{2n}{r-l} & 0 & \frac{r+l}{r-l} & 0 \ 0 & \frac{2n}{t-b} & \frac{t+b}{t-b} & 0 \ 0 & 0 & -\frac{f+n}{f-n} & -\frac{2fn}{f-n} \ 0 & 0 & -1 & 0 \end{bmatrix}$$
当你把一个三维空间中的点 $(x, y, z, 1)^T$ 乘以这个矩阵后,得到的裁剪空间坐标 $(x', y', z', w')^T$ 中:
- $w'$ 分量变成了 $-z$(即原始相机空间中深度值的相反数)。
- $z'$ 分量则变成了一个关于 $z$ 的线性组合(包含 $\frac{1}{z}$ 的潜力项)。
7、Z-Fighting 是什么?如何解决这一问题?
当两个平面在空间中靠得非常近时,由于 Depth Buffer 存储深度的有限浮点数精度,特别是透视投影导致的远端非线性精度衰减,GPU 在深度测试时无法精准区分谁在前谁在后,导致两个平面的像素在屏幕上交替穿插闪烁的现象。
常见的 Z-Fighting 解决方案包括:
- 多边形偏移:调用 glEnable(GL_POLYGON_OFFSET_FILL) 并设置 glPolygonOffset(factor, units),给渲染的贴面/线框人为施加微小的深度偏置(Biasing)。
- 拉远近平面:近平面 $n$ 对深度精度分布影响极大。将 $n$ 从 0.01 提升到 0.1 或 1.0 可以极大地缓解远端的精度挤压。
- 增加 Depth Buffer 精度位数:从 GL_DEPTH_COMPONENT16 切换到 GL_DEPTH_COMPONENT24 或 GL_DEPTH_COMPONENT32F(32 位浮点深度)。
- 合并/裁剪重叠几何体:在建模阶段避免物理上完全重合的平面。
- 采用 Reversed-Z 技术。
8、Reversed-Z 如何解决了 Z-Fighting 问题?此时的z坐标值范围是多少?是否需要修改glDepthFunc函数?
IEEE 754 标准的单精度浮点数(Float32)包含 1 个符号位、8 个指数位和 23 个尾数位。浮点数在 $[0.5, 1.0]$ 范围内的可表示数值密度远远低于在 $[0.0, 0.5]$(指数位更小)范围内的密度。
传统映射:近平面映射到 $0.0$,远平面映射到 $1.0$。也即在NDC空间到Screen Space的变换中,z的坐标值会从[-1, 1]映射到[0, 1]。当然也可以调用glDepthRange函数来修改这个最终范围。
不过,由于相机透视投影的非线性性质,NDC空间下的z坐标值与View空间下的z坐标值是呈反比的,这导致深度变化最剧烈的远端场景恰好被分在了浮点数精度最低的 $[0.5, 1.0]$ 区间。
比如:远端的物体(比如 100 米和 101 米)本身就极难区分,需要很高的精度;但透视投影偏偏把它们挤在了 精度最差、最容易发生小数点舍入重合的 1.0 附近,导致深度测试时无法精准区分谁在前谁在后。
为了解决“远端物体落入 1.0 低精度区”的悲剧,Reversed-Z 做了一个非常彻底的颠倒——将投影矩阵和映射逻辑改成:
- 近平面(Near Plane) $\to \text{Depth Buffer} = \mathbf{1.0}$(靠近相机)
- 远平面(Far Plane) $\to \text{Depth Buffer} = \mathbf{0.0}$(远离相机)
具体而言,实现 Reversed-Z 包括三步:
- 首先,修改glm::perspective函数,将near和far交换(默认是near在前,far在后)。
- 其次,调整 NDC 空间的z轴坐标范围,毕竟Reversed-Z的核心在于利用浮点数在靠近 0 的高精度区。调用 glClipControl(GL_LOWER_LEFT, GL_ZERO_TO_ONE) 将默认的 NDC 空间的z轴坐标范围从 $[-1.0, 1.0]$ 改为 $[0.0, 1.0]$。
- 最后,修改深度测试函数和清屏状态,其调用代码如下。
// 初始化阶段设置
glEnable(GL_DEPTH_TEST);
glDepthFunc(GL_GREATER);  // 比当前深度值更大(更近)的像素通过测试
glClearDepth(0.0f);       // 清屏时,深度默认写为最远处的 0.0

// 每帧渲染循环内
glClearDepth(0.0f);
glClear(GL_COLOR_BUFFER_BIT | GL_DEPTH_BUFFER_BIT);
Fixed-Function Hardware
在 GPU Pipeline 中,除了 Vertex Shader、Fragment Shader 和 Compute Shader 等由用户自定义的可编程阶段外,还存在由 GPU 硬件专用电路(Fixed-Function Hardware) 实现的固化功能阶段。
Primitive Setup:
| 步骤名称 | 原理作用 | 控制 API | 特别注意 |
|---|---|---|---|
| 图元装配 (Primitive Assembly) | 根据绘制指令(如 GL_TRIANGLES、GL_TRIANGLE_STRIP、GL_LINES 等),将 Vertex Shader 输出的顶点组合成对应的点、线段或三角形等几何图元 |
由 Draw Call 参数指定(如 glDrawArrays / glDrawElements 的第一个参数) |
顶点属性插值的前提条件;若顶点索引或环绕顺序配置错误,会导致后续图元构建异常 |
| 视锥体裁剪 (Clipping) | 自动判定几何图元是否超出 Clip Space 范围。对于跨越视锥体边界的图元,硬件会自动将其裁切,并在边界处生成新的顶点(在透视除法前完成) | 自动执行(也可通过 GLSL gl_ClipDistance[] 手动控制特定裁剪面) |
裁剪在齐次剪裁坐标系下进行,能防止对视锥体外的图元进行无效透视除法以及后续的光栅化浪费 |
| 背面剔除 (Face Culling) | 根据顶点在屏幕空间的环绕顺序(顺时针 CW / 逆时针 CCW)判定三角形正反面,直接丢弃背对相机的图元,避免无效进入光栅化与 Fragment Shader | glEnable(GL_CULL_FACE) glCullFace(GL_BACK) glFrontFace(GL_CCW) |
必须严格保持模型顶点环绕顺序的一致性;渲染透明物体或具有内壁的几何体(如双面材质、天空盒)时通常需要关闭背面剔除 |
| 视口变换 (Viewport Transform) | 硬件自动进行透视除法(归一化为 NDC 空间 $ [-1,1]^3 $ )后,将 NDC 坐标映射转换到实际屏幕像素坐标系(Screen Space,如 1920×1080) | glViewport(x, y, width, height) glDepthRange(near, far) |
窗口 resize 时必须同步更新 glViewport,否则会导致图像拉伸歪曲或像素映射区域错误;glDepthRange 用于控制 Z 值映射到深度缓冲区的范围(默认 0.0~1.0) |
Rasterization & Interpolation:
| 核心步骤/机制 | 原理作用 | 硬件执行细节 / 关键特性 | 控制 API / 关键字 |
|---|---|---|---|
| 光栅化器 (Rasterizer) | 判定哪些像素中心(Pixel Center)落在图元(如三角形)内部,将连续的几何图元离散化为一个个片元(Fragment) | 1. Quad 组装:硬件按 $2 \times 2 $ 像素块(Quad)为基本单位分发 Fragment,哪怕三角形只覆盖了 Quad 中的 1 个像素,整个 Quad 的 4 个 Fragment 都会被强制激活执行2. Top-Left 规则:解决相邻三角形共享边缘时的重复光栅化问题 | glPolygonMode(控制填充/线框/点)glEnable(GL_MULTISAMPLE)(MSAA) |
| 透视矫正插值 (Attribute Interpolation) | 根据三角形三个顶点的属性(如 UV、Normal、Color),自动计算当前 Fragment 对应的插值结果并传给 FS | 透视矫正(Perspective-Correct):由于透视投影后 $ Z $ 轴非线性,硬件利用 $ \frac{1}{w} $ 空间进行齐次线性插值,再除以 $ \frac{1}{w} $ 复原,消除近大远小导致的插值扭曲 | GLSL 限定符:• smooth(默认,透视矫正插值)• noperspective(屏幕空间线性插值)• flat(禁用插值,使用 Provoking Vertex) |
| 硬件偏导数计算 (Derivatives / Quad Differences) | 计算任意顶点/片元变量在屏幕空间 $ X/Y $ 方向的变化率(即 $ \frac{\partial}{\partial x}, \frac{\partial}{\partial y} $ ) | Quad 内寄存器差值:因为 Quad 里的 4 个像素在 SIMD 通道中完全同步运行,硬件可以直接读取同一 Quad 内邻居像素的变量数值求差(例如 $ \text{dFdx}(v) = v_{(x+1,y)} - v_{(x,y)} $ ),开销极低 | GLSL 内建函数:• dFdx(v) / dFdy(v)• fwidth(v)( $ \left\Vert{}\text{dFdx}\right\Vert{} + \left\Vert{}\text{dFdy}\right\Vert{} $ ) |
1、硬件偏导数的执行过程?为什么说它是默认执行的?
- Quad($2\times 2$ 像素块)打包:光栅化器(Rasterizer)分发片元时,强制将屏幕空间相邻的 $2\times 2$ 像素打包为一个 Quad,并在 GPU 的 SIMD/SIMT 单元中完全同步执行。
- Helper Pixels(辅助片元)标记:若三角形仅覆盖 Quad 中的部分像素,其余像素会被标记为辅助片元,强制陪跑 FS 计算以提供邻域数据,但其计算结果不写入 Buffer。
- 寄存器数据求差:执行求导指令时,同一 Quad 内的线程通过 GPU 内部数据总线(Quad Shuffle)互相读取对方寄存器中的变量值,直接相减得出 $X$ 和 $Y$ 方向的变化率:
2、如何在 GLSL 中使用硬件偏导数?它除了隐式调用用于 MipMap 层级计算外,还可以做什么?
GLSL 使用接口包括:
- dFdx(v) / dFdy(v):计算变量 $v$ 在屏幕 $X$ / $Y$ 轴方向的变化率。
- fwidth(v):等价于 $\vert{}dFdx(v)\vert{} + \vert{}dFdy(v)\vert{}$,用于衡量变量在屏幕空间的剧烈变化程度。
常见的其他应用则包括:
- 重建几何面法线:
vec3 flatNormal = normalize(cross(dFdx(v_WorldPos), dFdy(v_WorldPos)));; - 程序化纹理矢量抗锯齿。
Test & Merge:
| 执行顺序 | 测试/融合名称 | 原理作用 | 控制 API | 特别注意 |
|---|---|---|---|---|
| 1 | 裁剪测试 (Scissor Test) | 判定片元坐标 $ (x,y) $ 是否落在指定矩形区域内,超出范围则直接抛弃,用于 UI 局部剪裁或渲染区域限制 | glEnable(GL_SCISSOR_TEST)``glScissor(x, y, width, height) |
独立于视口变换(glViewport);测试失败的片元不会触发后续任何 Stencil/Depth 读取,性能开销极低 |
| 2 | Alpha 测试 / 多采样掩码 (Alpha Test / Sample Mask) | Alpha Test:根据 Alpha 值阈值判定是否丢弃片元(固定管线遗留);Sample Mask:MSAA 下根据覆盖率掩码决定计算哪些 Sample | glEnable(GL_SAMPLE_ALPHA_TO_COVERAGE)``glSampleMaski(index, mask)(注:可编程管线中 Alpha Test 通常用 GLSL discard 替代) |
使用 MSAA 时,Alpha-to-Coverage 可将 Alpha 值转换为子采样点掩码,实现平滑的透光剔除,缓解 discard 带来的硬边缘锯齿 |
| 3 | 模板测试 (Stencil Test) | 将片元的 Stencil 值与 Stencil Buffer 中的参考值(Reference)进行比较,控制特定区域的绘制。常用于实现蒙版、遮罩、镜面剔除及轮廓线绘制 | glEnable(GL_STENCIL_TEST) glStencilFunc(func, ref, mask) glStencilOp(sfail, dpfail, dppass) glStencilMask(mask) |
优先于深度测试执行;只有当模板测试与深度测试均通过时才会触发 dppass 更新操作;未开启时不会写入 Stencil Buffer |
| 4 | 深度测试 (Depth Test) | 比较当前片元的 $ Z $ 值与 Depth Buffer 中已有的 $ Z $ 值。若测试失败则直接丢弃片元(不写入颜色与深度),用于确定物体的几何前后遮挡关系 | glEnable(GL_DEPTH_TEST) glDepthFunc(func) glDepthMask(flag) |
glDepthMask(GL_FALSE) 关闭深度写入(半透明物体必设);在 FS 中修改 gl_FragDepth 或使用 discard 会破坏硬件 Early-Z 优化 |
| 5 | Alpha 混合 (Color Blending) | 将 Fragment Shader 输出的颜色(Source Color)与 Framebuffer 现有的颜色(Destination Color)按指定公式(如 Src * Alpha + Dst * (1 - Alpha))进行数学融合,用于渲染半透明物体、玻璃、粒子系统等 |
glEnable(GL_BLEND) glBlendFunc(sfactor, dfactor) glBlendEquation(mode) |
渲染半透明物体时,必须关闭深度写入(glDepthMask(GL_FALSE)),且几何体绘制严格遵循从后往前(Back-to-Front)的排序,否则会产生严重的混合错乱 |
1、Early-Z 是什么?它如何使用,有独立的 API 吗?
Early-Z 是一种基于硬件的深度测试优化优化机制,用于在光栅化阶段提前丢弃一些片元,从而减少后续的渲染工作量。
作为一项硬件层面的管线优化机制,Early-Z 并没有提供独立的控制 API。准确地说,在现代 OpenGL 中,只要开启了深度测试(glEnable(GL_DEPTH_TEST)),驱动与 GPU 硬件默认总是会主动尝试触发 Early-Z 优化;开发者无需手动开启它,管线只会因触发特定限制而被迫关闭它。
- 片元着色器中显式修改了深度:在 FS 中手动写入 gl_FragDepth,使 GPU 无法在光栅化阶段提前预测片元的真实深度。
- 使用了片元抛弃指令:在 FS 中使用了 discard 或 clip() 指令,导致 GPU 无法在光栅化阶段提前安全地更新 Depth Buffer(避免污染深度数据)。
- 开启了依赖 FS 的 Alpha 操作:例如开启了 Alpha-to-Coverage 或在 FS 中动态改变透明度掩码,使片元的存活状态依赖于 FS 的运行结果。
- 关闭了深度测试或处于不兼容的渲染状态:例如未启用 GL_DEPTH_TEST,或采用了不兼容 Early-Z 的特定硬件透视校正模式。
2、考虑到显存带宽消耗问题,Early-Z 优化在 Deferred Rendering 模式下还有必要吗?GPU-Driven Pipeline 如何对其进行了进一步的优化。
除了由渲染API直接提供的Early-Z测试,现代游戏引擎还将这种Early-Z的思想,与Deferred Rendering技术相结合,直接作为渲染管线中的独立Pass存在。比如:UE5中GPU-Driven的最佳实践——Nanite就将这种Early-Z的思想推向了极致,并演进为了生成Visibility Buffer的Deferred Geometry Pass。
传统的 Deferred Rendering 需要在 Geometry Pass 中向显存写入包含颜色、法线等多张大纹理的G-Buffer,这会带来高昂的显存带宽开销。而Nanite的Visibility Buffer管线选择在第一阶段只运行一个极致精简的Early-Z变种 Pass:它不计算也不存储任何材质属性,光栅化后在屏幕上仅输出Depth以及一张记录着Primitive ID、Instance ID以及Material ID的极精简缓冲区。在随后的材质着色阶段,引擎再启动全屏后处理,像素通过读取自身的ID,直接去显存缓冲区中乱序抓取对应的顶点数据并原地进行数学插值,最后根据Material ID索引对应的材质进行着色。
这种演进彻底颠覆了传统管线盲目向显存塞入海量材质属性的低效模式,通过“先算可见性、后抓取属性”的逻辑,将显存写入的带宽开销降低了 80% 以上,成为了现代 GPU-Driven 渲染体系的核心基石。
3、Hi-Z 是什么?它如何使用,有独立的 API 吗?
Hi-Z(Hierarchical Z-Buffer,分层深度测试) 是一种内嵌于 GPU 硬件(Fixed-Function Hardware)中的粗粒度深度剔除(Early Occlusion Culling)加速电路。如果说 Early-Z 是在片元着色器(FS)执行前逐像素(Pixel / $2 \times 2$ Quad)检查 $Z$ 值,那么 Hi-Z 就是在光栅化阶段之前或初期,以块/瓦片(Tile / Block,如 $8\times 8$ 或 $16\times 16$ 像素)为单位进行的批量深度剔除。
GPU 硬件会在 On-Chip SRAM / L2 Cache 中维护一套低分辨率的 $Z_{min} / Z_{max}$ 层次树(类似于深度图的 Mipmap 金字塔):
- 在图元进入光栅化前,硬件首先将图元的深度与当前 Tile 的 Hi-Z 边界($Z_{max}$ 或 $Z_{min}$)进行比对。
- 若整个 Tile 的几何体都被判定为被遮挡(Occluded),GPU 会直接丢弃整个 Tile。
这种机制大幅节省了对后续光栅化插值、Early-Z 逐像素测试以及 Depth Buffer 的显存读写带宽。
4、GPU-Driven Pipeline 中是如何使用软件实现 Hi-Z 算法的?它与硬件 Hi-Z 有什么区别?双Pass Hi-Z 是什么?
上一个问题提到的 Hi-Z 是基于 GPU 内部 Hi-Z 硬件 unit 所实现的,也即硬件Hi-Z。它的核心在于,使用 8 x 8 像素块(Tile)为单位进行批量深度测试大大减少了后续的渲染工作量。
至于软件 Hi-Z,它一般是指 GPU-Driven Pipeline 中在 Compute Shader 中实现的 Hi-Z 优化。相比硬件 Hi-Z 在光栅化后执行、且以像素块为单位,软件 Hi-Z 则是在光栅化前执行、且以 Mesh 为单位。具体而言,它包括两步:
- 使用上一帧的 Z Buffer 生成完整的 Mipmap 链,也即所谓的 Hireachy Z Buffer Mipmap。其中,每个 $2 \times 2$ 像素块必须取最大深度值(max),确保保存的是该区域内最远的平面深度。
- 接着,使用 Compute Shader 进行剔除采样。
为接近因为场景内物体移动或相机视角变换造成的上一帧 Z Buffer 中的深度值不准确,软件 Hi-Z 还需要进行一些额外的处理,也即双Pass Hi-Z,它的步骤如下:
- 预剔除:使用上一帧的 Hi-Z 金字塔剔除当前帧物体。预测可见的物体立即渲染,并写入当前帧深度;预测被遮挡的物体放入“待复查列表”。
- 构建当前帧 Hi-Z:根据 Pass 1 渲染出的最新 Depth Buffer,现场生成当前帧的 Hi-Z 金字塔。
- 补漏复查:读取“待复查列表”,用当前帧刚刚生成的 Hi-Z 进行二次验证。若因相机运动导致原本被遮挡的物体露出来了,补充渲染它们,彻底消除漏显与闪烁。
GPU-Driven Pipeline
Global Illumination
在图形学中,光源直接照射物体产生的光照效果称为局部光照(Local Illumination),也即直接光照(Direct Lighting);而光线在场景物体间经过多次反射、折射或散射后产生的二次及多次光照,则称为间接光照(Indirect Lighting)。结合了直接光与间接光、能够真实模拟光线在整个场景中传播与能量平衡的渲染模型,统称为全局光照(Global Illumination,简称 GI)。
通过对入射光和出射光的物理建模,图形学研究者提出了双向反射分布函数和各种基于物理的渲染材质理论,已然对直接光照实现良好的模拟与渲染。为了进一步提升图像的写实度与空间沉浸感,渲染系统必须引入对间接光照的计算。
在物理本质上,计算间接光照总是逃不过对光线传播路径的追踪(Ray Tracing/Marching)。为了在视觉效果与计算复杂度之间取得平衡,现有的全局光照算法根据计算发生的时间节点,主要分为两大类:
- 基于预计算的全局光照算法:核心思想在于“空间换时间”。在渲染前(离线阶段)将场景内物体的光照与遮挡信息预先计算好,并存储到 2D 光照贴图(Lightmaps)、3D 体素/探针网格(Volumetric Lightmaps / APV) 或 环境反射探针(Reflection Probes) 中。在实时渲染阶段,直接通过 $O(1)$ 或极低开销的查表与插值,即可获取全局光照效果。
- 实时全局光照算法(动态 GI):除了依赖现代 GPU 硬件光线追踪外,主流算法主要通过各种简化空间结构与近似求交的软件光追手段进行加速,主要包括:
- 屏幕空间(Screen-Space):如 SSGI、SSR,利用 G-Buffer 的 2D 深度与法线信息进行 Ray Marching。
- 体素化(Voxelization):如 VXGI、LPV,将场景简化为 3D 体素网格并进行锥体追踪(Cone Tracing)或球谐函数(SH)扩散。
- 虚拟点光源法(Virtual Point Light):如 RSM,将光源视角可见的表面转化为微型点光源计算一次漫反射反弹。
- 距离场与表面缓存(Signed Distance Field With Surface Cache):如 UE5 Lumen 光照系统,利用符号距离场进行 Sphere Tracing 极速求交,并结合 Surface Cache 读取表面辐射度。
IBL
1、Irradiance Map 的定义与作用
Irradiance Map(辐照度图)是基于图像光照(IBL)中用于计算漫反射(Diffuse IBL)的预计算环境贴图。它的本质是一张环境 CubeMap,贴图中坐标方向为 $\mathbf{N}$ 的像素,存储的就是以 $\mathbf{N}$ 为法线方向的整个半球半空间内所有入射光线的加权积分值。在渲染阶段,Shader 直接使用表面法线 $\mathbf{N}$ 采样该贴图,即可在 $O(1)$ 时间内获取漫反射光照。
Irradiance Map 的物理计算公式根据朗伯余弦定律,表面接收到的漫反射辐照度 $E(\mathbf{N})$ 是入射辐射率 $L_{in}(\omega_i)$ 在半球域 $\Omega$ 上的加权积分:
#version 330 core
out vec4 FragColor;
in vec3 WorldPos;

uniform samplerCube environmentMap;
const float PI = 3.14159265359;

void main() {
    vec3 N = normalize(WorldPos);
    vec3 irradiance = vec3(0.0);

    vec3 up    = abs(N.z) < 0.999 ? vec3(0.0, 0.0, 1.0) : vec3(1.0, 0.0, 0.0);
    vec3 right = normalize(cross(up, N));
    up         = cross(N, right);

    float sampleDelta = 0.025;
    float nrSamples = 0.0;

    for (float phi = 0.0; phi < 2.0 * PI; phi += sampleDelta) {
        for (float theta = 0.0; theta < 0.5 * PI; theta += sampleDelta) {
            vec3 tangentSample = vec3(sin(theta) * cos(phi), sin(theta) * sin(phi), cos(theta));
            vec3 sampleVec = tangentSample.x * right + tangentSample.y * up + tangentSample.z * N;

            irradiance += texture(environmentMap, sampleVec).rgb * cos(theta) * sin(theta);
            nrSamples++;
        }
    }

    irradiance = PI * irradiance * (1.0 / float(nrSamples));
    FragColor = vec4(irradiance, 1.0);
}
2、球谐函数(Spherical Harmonics, SH)
球谐函数(Spherical Harmonics, SH)是定义在二维单位球面上的正交基函数,即“二维球面上的傅里叶级数”。它在图形学内常用于表示光照函数。
由于 Irradiance 的计算本质上是用余弦核 $\cos\theta$ 对环境光做卷积,该加权积分在频域上是一个剧烈的低通滤波器(Low-pass Filter),抹平了所有高频细节,使高频能量衰减了 99% 以上。因此,仅需使用前 3 阶球谐函数(共 9 个 RGB 系数,仅占 108 字节)即可高度精准地还原整张模糊的 Irradiance Map,且在 Shader 着色时无需任何纹理采样,仅凭 9 个系数的多项式计算即可求出光照。
3、IBL Specular近似Split Sum近似的原理和缺陷。也即,为什么允许使用 Split Sum 近似来近似 IBL Specular?
在数学上,两个函数乘积的积分通常不能直接拆分。但如果函数 $f(x)$ 在积分域上变化平缓(或可视为常数),而 $g(x)$ 变化剧烈且波峰极度集中(类似于 $\delta$ 冲激函数),则可以将“乘积的积分”近似拆分为“均值与积分的乘积”:
$$\int_{\Omega} f(x) g(x) dx \approx \left( \frac{\int_{\Omega} f(x) dx}{\int_{\Omega} 1 , dx} \right) \cdot \left( \int_{\Omega} g(x) dx \right)$$
进一步扩展可以得到加权拆分的积分公式:
$$\int_{\Omega} f(x) g(x) w(x) dx \approx \left( \frac{\int_{\Omega} f(x) w(x) dx}{\int_{\Omega} w(x) , dx} \right) \cdot \left( \int_{\Omega} g(x) w(x) dx \right)$$
其中,加权因子 $w(x)$ 可以视作从 $g(x)$ 中提取出的冲激函数。
在 IBL Specular 积分中,充当这个“极度收敛函数 $w(x)$”的正是 BRDF 中的 GGX 微表面分布函数 $D(\mathbf{h})$ 。具体而言,
- GGX NDF(微表面分布)的波峰极度集中:对于绝大多数中低粗糙度的材质,GGX NDF $D(\mathbf{h})$ 是一个极其狭窄的高峰,且其峰值完全由观察视角 $\mathbf{v}$ 与表面法线 $\mathbf{n}$ 决定。这意味着 BRDF 绝大部分能量都集中在镜面反射主方向(Specular Lobe)附近的极小半球区域内。
- 环境光 $L_i$ 在该局部区域内可视为平缓变化:由于 BRDF 的波峰极其狭窄,在这个狭小的采样子集内,可以假定入射光 $L_i(\omega_i)$ 的变化是相对平缓的,可以直接用反射主方向 $\mathbf{R}$ 处的采样值来代表整个 Specular Lobe 覆盖区域内的平均入射光。
基于上述条件,Split Sum 将原积分拆解为两个可独立求解的子项:$$\begin{aligned} L_o(\mathbf{v}) &\approx \underbrace{\left( \frac{\int_{\Omega} L_i(\mathbf{\omega}_i) D(\mathbf{h}) (\mathbf{n} \cdot \mathbf{\omega}_i) , d\mathbf{\omega}i}{\int{\Omega} D(\mathbf{h}) (\mathbf{n} \cdot \mathbf{\omega}i) , d\mathbf{\omega}i} \right)}{\text{第一项:预滤波环境贴图 (Prefiltered Environment Map)}} \cdot \underbrace{\int{\Omega} f_r(\mathbf{\omega}_i, \mathbf{v}) (\mathbf{n} \cdot \mathbf{\omega}_i) , d\mathbf{\omega}i}{\text{第二项:环境 BRDF 2D LUT}} \end{aligned}$$
- Prefiltered Environment Map:预卷积环境光(只与反射方向 $\mathbf{R}$ 和 Roughness 相关的离散 Mipmap 链)。
- Environment BRDF 2D LUT:预积分材质本身的几何与波形响应(只与 $\cos\theta$ 和 Roughness 相关)。
此时,便可分别预计算两个子项。其中,观察Prefiltered Map可以发现,它同时受到法线、视线方向(与光线共同决定半角向量方向)以及粗糙度的影响。若在预计算时严格保留所有变量,该积分结果则需要一个高维度的纹理数据结构(如 CubeMap Array 结合 3D 采样),存储开销与计算复杂度在实时渲染中无法接受。
为了简化计算,再次引入了一个关键假设,也即:假设视角方向 $V$、法线方向 $N$ 与反射主方向 $R$ 三者完全重合( $V = N = R$)。在此假设下,半角向量 $H$ 的采样分布直接收敛于以 $N$ 为中心的高光波瓣,使得预滤波函数仅取决于反射主方向 $R$ 和粗糙度 $\text{Roughness}$。最终,不同粗糙度的预滤波环境光可以被顺序存入标准 CubeMap 的不同 Mipmap 层级中。
在利用蒙特卡洛(Monte Carlo)数值求解该积分时,若采用均匀采样,需要极高数量的光线才能收敛。因此,实践中采用基于 GGX 法线分布函数 $D(\mathbf{h})$ 的重要性采样(Importance Sampling)。
已知根据 $D(\mathbf{h})$ 分布采样的概率密度函数(PDF)为:$$p(\mathbf{\omega}_i) = \frac{D(\mathbf{h}) (\mathbf{n} \cdot \mathbf{h})}{4 (\mathbf{v} \cdot \mathbf{h})}$$在 $V = N$ 的假设下,$\mathbf{v} \cdot \mathbf{h} = \mathbf{n} \cdot \mathbf{h}$,采样概率密度简化为 $p(\mathbf{\omega}_i) = \frac{D(\mathbf{h})}{4}$。将蒙特卡洛积分公式 $I \approx \frac{1}{N} \sum \frac{f(\mathbf{\omega}_i)}{p(\mathbf{\omega}i)}$ 代入分子与分母:分子项:$$\int{\Omega} L_i(\mathbf{\omega}_i) D(\mathbf{h}) (\mathbf{n} \cdot \mathbf{\omega}_i) , d\mathbf{\omega}i \approx \frac{1}{N} \sum{i=1}^N \frac{L_i(\mathbf{\omega}_i) \cdot D(\mathbf{h}_i) \cdot (\mathbf{n} \cdot \mathbf{\omega}_i)}{\frac{D(\mathbf{h}i)}{4}} = \frac{4}{N} \sum{i=1}^N L_i(\mathbf{\omega}_i) (\mathbf{n} \cdot \mathbf{\omega}i)$$分母项:$$\int{\Omega} D(\mathbf{h}) (\mathbf{n} \cdot \mathbf{\omega}_i) , d\mathbf{\omega}i \approx \frac{1}{N} \sum{i=1}^N \frac{D(\mathbf{h}_i) \cdot (\mathbf{n} \cdot \mathbf{\omega}_i)}{\frac{D(\mathbf{h}i)}{4}} = \frac{4}{N} \sum{i=1}^N (\mathbf{n} \cdot \mathbf{\omega}i)$$分子与分母中的法线分布项 $D(\mathbf{h})$ 与采样概率分母完全约分抵消,最终 Prefiltered Map 的离线计算公式成功简化为极简的加权累加形式:$$\text{PrefilteredColor}(R, \text{Roughness}) \approx \frac{\sum{i=1}^N L_i(\mathbf{\omega}_i) \cdot (\mathbf{n} \cdot \mathbf{\omega}i)}{\sum{i=1}^N (\mathbf{n} \cdot \mathbf{\omega}_i)}$$这表明,在工程实现中,$D(\mathbf{h})$ 的作用已隐式转化为引导采样光线 $\mathbf{\omega}_i$ 在半球空间中的生成概率,而无需在像素颜色累加时显式计算并乘以 $D(\mathbf{h})$。
另一方面,对于 BRDF LUT 的计算而言,带入 Cook-Torrance 的镜面反射系数,并使用 Schlick 近似 Fresnel 项。
$$f_r(\mathbf{\omega}_i, \mathbf{v}) = \frac{D(\mathbf{h}) \cdot F(\mathbf{\omega}_i, \mathbf{h}) \cdot G(\mathbf{\omega}_i, \mathbf{v}, \mathbf{h})}{4 (\mathbf{n} \cdot \mathbf{v}) (\mathbf{n} \cdot \mathbf{\omega}_i)}$$在这里,Fresnel 项 $F$ 使用 Schlick 近似:$$F(\mathbf{\omega}_i, \mathbf{h}) = F_0 + (1 - F_0) (1 - \mathbf{v} \cdot \mathbf{h})^5$$
$$F(\mathbf{\omega}_i, \mathbf{h}) = F_0 + (1 - F_0) (1 - \mathbf{v} \cdot \mathbf{h})^5$$
此时,可得到积分公式为:
$$ F_0 \cdot \underbrace{\int_{\Omega} \frac{f_r}{F} \left( 1 - (1 - \mathbf{v} \cdot \mathbf{h})^5 \right) (\mathbf{n} \cdot \mathbf{\omega}i) , d\mathbf{\omega}i}{\text{缩放项 Scale } (A)} + \underbrace{\int{\Omega} \frac{f_r}{F} (1 - \mathbf{v} \cdot \mathbf{h})^5 (\mathbf{n} \cdot \mathbf{\omega}_i) , d\mathbf{\omega}i}{\text{偏移项 Bias } (B)} $$
换句话说,任何材质的 IBL BRDF 积分结果都可以写为:$$I_{\text{BRDF}} = F_0 \cdot A + B$$
该积分结果仅视角与法线的夹角余弦值以及材质的粗糙度相关。因此,我们可以提前建立一张 $256 \times 256$ 的 2D RG 查找表 (LUT):
- 横坐标 $X$:$\mathbf{n} \cdot \mathbf{v} \in [0, 1]$
- 纵坐标 $Y$:$\text{Roughness} \in [0, 1]$
- Red 通道:存储 $A$(Scale 缩放系数)
- Green 通道:存储 $B$(Bias 偏移系数)
与 Prefiltered Map 计算方法类似,BRDF LUT 同样采用蒙特卡洛配合 GGX 重要性采样的方式计算。以缩放系数 A 为例,它化简后为:
$$A = \int_{\Omega} \frac{D(\mathbf{h}) \cdot G(\mathbf{\omega}_i, \mathbf{v}, \mathbf{h})}{4 (\mathbf{n} \cdot \mathbf{v})} \cdot \left( 1 - (1 - \mathbf{v} \cdot \mathbf{h})^5 \right) d\mathbf{\omega}_i$$
据蒙特卡洛积分公式 $I \approx \frac{1}{N} \sum_{i=1}^N \frac{f(\mathbf{\omega}_i)}{p(\mathbf{\omega}_i)}$,将被积函数 $f(\mathbf{\omega}_i)$ 和 GGX 概率密度 $p(\mathbf{\omega}i)$ 代入:$$\begin{aligned} A &\approx \frac{1}{N} \sum{i=1}^N \frac{\frac{D(\mathbf{h}_i) \cdot G(\mathbf{\omega}_i, \mathbf{v}, \mathbf{h}_i)}{4 (\mathbf{n} \cdot \mathbf{v})} \cdot \left( 1 - (1 - \mathbf{v} \cdot \mathbf{h}_i)^5 \right)}{\frac{D(\mathbf{h}_i) (\mathbf{n} \cdot \mathbf{h}_i)}{4 (\mathbf{v} \cdot \mathbf{h}_i)}} \end{aligned}$$
$$A \approx \frac{1}{N} \sum_{i=1}^N \underbrace{\left( \frac{G(\mathbf{\omega}_i, \mathbf{v}, \mathbf{h}_i) \cdot (\mathbf{v} \cdot \mathbf{h}i)}{(\mathbf{n} \cdot \mathbf{v}) \cdot (\mathbf{n} \cdot \mathbf{h}i)} \right)}{\text{几何与可见性相对权重 } G{\text{Vis}}} \cdot \left( 1 - (1 - \mathbf{v} \cdot \mathbf{h}_i)^5 \right)$$
同理,偏移系数 $B$ 的化简结果仅需将后半段替换为 $(1 - \mathbf{v} \cdot \mathbf{h}_i)^5$ 即可。
综上所述,基于数学拆分与工程优化的推导过程,Split Sum 方案能够成立并保持较高真实度,严格依赖于以下三大前提假设:
- 环境光 $L_i$ 变化平缓:在高光波瓣(Specular Lobe)覆盖的极小局部半球区域内,入射环境光不能有剧烈的频域突变。
- 材质粗糙度 $\text{Roughness}$ 较低:此时 GGX 分布 $D(\mathbf{h})$ 波瓣极度狭窄收敛(类似于 $\delta$ 冲激函数),作为加权滤波核能强行将有效积分域约束在极小范围,满足积分近似拆分的数学条件。
- 视角与法线重合假设($V = N = R$):为了将 Prefiltered Map 的采样维度降至 2D(利用 Mipmap CubeMap 存储),假设视角方向、法线方向与反射主方向同向。
当上述假设在实际渲染场景中被打破时,Split Sum 方案会导致以下物理不真实(Artifacts)表现:
- 高粗糙度下的能量偏差与过暗问题:当粗糙度增加时,$D(\mathbf{h})$ 的波瓣极度扩散,不再满足“尖峰”假设。环境光 $L_i$ 在宽广的积分域内剧烈变化,导致拆分公式产生严重的累加误差;同时由于未包含多重散射(Multiple Scattering)能量补偿,高粗糙度金属材质会出现明显偏暗的现象。
- 掠射角(Grazing Angles)下的高光拉伸失真与不正常亮暗:由于 Prefiltered Map 强行假设了 $V = N$,强制将预滤波采样约束为各向同性的圆形波瓣。但在视角大倾角(掠射角,即 $V \cdot N \to 0$)下,真实的 Specular Lobe 会沿视角方向严重拉伸为椭圆形(Grazing Stretch)。
- Split Sum 无法捕获这种各向异性的波瓣拉伸,导致掠射角下的边缘高光出现形状拖尾缺失、亮度不自然过亮或过暗等不符合物理几何的情况。环境光阴影与自遮挡丢失:Split Sum 默认半球空间内的环境光完全无遮挡,无法表达复杂几何体自阴影带来的环境高光遮挡(Specular Occlusion),在缝隙或凹陷处容易出现“漏光”现象。
4、BRDF LUT 是否可以用于场景内所有物体?
不完全正确,应该说全场景绝大多数 PBR 材质都共用同一个全局 2D BRDF LUT 纹理。因为,它完全消除了 $F_0$(基础反射率,即金属度/颜色参数) 和 $L_i$(入射环境光强度/颜色)的干扰,仅受视角与法线的夹角余弦值以及材质的粗糙度相关。
Probe
1、Probe 是什么技术?现代游戏引擎中有哪些 Probe?它们各自的特点是什么?适合使用在什么场景下?
| 探针类型 | 代表方案 | 光照信息 | 数据格式 | 物理特性 | 适用场景 |
|---|---|---|---|---|---|
| 光照探针 (Light Probe) | Unity Light Probe Group | 低频漫反射(Diffuse GI) | 预计算球谐函数系数 | 低频、模糊、无高光细节,计算开销极低 | 动态角色/物体的间接光漫反射、静态缝隙处弥补光照 |
| 反射探针 (Reflection Probe) | Unity Reflection Probe | 中高频镜面反射(Specular GI) | 预过滤环境立方体贴图与BRDF查表 | 高频、含清晰反射轮廓,支持多级 Mipmap | 金属、水面、玻璃、大理石等中高光滑度材质的反射 |
2、在 Unity 中,Light Map 和 Light Probe 都是基于预计算的光照方案。二者有什么区别?分别适合用于什么情况?
尽管 Light Map 与 Light Probe 同属预计算烘焙方案,但它们所表示的内容却完全不同。其中,前者是将离线计算好的最终表面光照结果(视线无关的间接漫反射与阴影)直接烘焙并存储在 2D 贴图上,运行时 $O(1)$ 读取输出;而后者存的是空间离散点上的环境光场分布(低频 SH 球谐函数系数),不管高光与高频阴影,运行时必须结合物体的表面法线动态重建出光照。
3、请你详细说明 Light Probe 中球谐函数预计算以及运行时重建光照的流程。
传统 IBL 技术直接存储 CubeMap 贴图来表示 Irradiance Map,也即 Diffuse GI。然而,当场景中需要布置成百上千个 Light Probe时,如果每个探针都存储一张完整的 CubeMap,显存占用将呈爆炸式增长,这在实时渲染中是不可接受的。
为了解决这一问题,Unity 采用了球谐函数系数来紧凑地表示 Irradiance Map,而非直接存储 CubeMap 贴图。这是因为 Irradiance Map 本质上是任意位置的半球环境光辐照度之和。从图像处理的角度来看,Irradiance Map 就是 Skybox 的模糊版本,也即低频滤波后的结果。
换句话说,如果我们能够直接分解出环境光 L 内部的低频分量,采用类似傅里叶变换的思路将信号投影到一组正交基函数上进行频域表达,就能用极少的系数还原出足够精确的低频光照信息。而球谐函数恰好能够做到这一点:它类似于傅里叶变换中的 $e^{i\omega t}$基函数,是一组定义在球面上的正交基函数,能够将定义在球面上的函数分解为不同频率分量的线性组合。我们可以将其投影到球谐函数的正交基上,得到一组系数,这些系数就能紧凑地表示环境光的低频信息。
换句话说,由于环境光实际上是一个定义在球面上的函数(由一个三维方向向量决定输出),因而可以使用定义在球面上、使用三维向量作为输入的球谐函数作为基函数。
具体而言,将球面函数 $f(\mathbf{\omega})$ 投影到第 $l$ 阶第 $m$ 次的球谐基函数 $Y_l^m(\mathbf{\omega})$ 上,求解基函数对应的展开系数 $c_l^m$:$$c_l^m = \int_{S^2} f(\mathbf{\omega}) Y_l^m(\mathbf{\omega}) , d\mathbf{\omega}$$
利用球谐基函数的线性组合还原原始球面信号:$$f(\mathbf{\omega}) = \sum_{l=0}^{\infty} \sum_{m=-l}^{l} c_l^m Y_l^m(\mathbf{\omega})$$
4、在 IBL 技术中,Irradiance Map 以及 Prefiltered Map 都默认由位于场景中心的探针生成,这导致了在场景边缘的光照信息不准确。相比之下,Unity 的 Light Probe Group 技术不仅允许放置在场景边缘,且能够正确反映这种位置差异。请问这一点是如何实现的?
在传统的 IBL 技术中,无论是预过滤的 Prefiltered Map 还是卷积生成的 Irradiance Map,其本质都是假定环境光源位于无限远处,采样时仅依赖方向向量 $\mathbf{\omega}$ 进行 CubeMap 查找。以 Irradiance Map 为例,其生成流程如下:
// vertex shader
#version 450
layout(location = 0) in vec3 iVertPos;
layout(location = 0) out vec3 oFragDir;
uniform mat4 uViewProjMatrix;
void main() {
    oFragDir = normalize(iVertPos);
    gl_Position = uViewProjMatrix * vec4(iVertPos, 1.0);
}

// fragment shader
#version 450
layout(location = 0) in vec3 iFragDir;
layout(binding = 12) uniform samplerCube tSkyboxMap;
out vec4 oFragColor;
void main() {
    const float PI = 3.14159265359;
    const float Delta = 0.25;

    vec3 front = normalize(iFragDir);
    vec3 up    = vec3(0.0, 1.0, 0.0);
    if(abs(front.y) > 0.999) up = vec3(1.0, 0.0, 0.0);
    vec3 right = normalize(cross(front, up));
    up         = normalize(cross(right, front));

    int numSamples = 0;
    vec3 irradiance = vec3(0.0);
    for(float phi = 0.0; phi < 2.0 * PI; phi += Delta) {
        for(float theta = 0.0; theta < 0.5 * PI; theta += Delta) {
            vec3 sampleVec = vec3(sin(theta) * cos(phi),  sin(theta) * sin(phi), cos(theta));

            // Convert into world space
            sampleVec = sampleVec.x * right + sampleVec.y * up + sampleVec.z * front;

            // Sample environment map
            irradiance += texture(tSkyboxMap, sampleVec).rgb * cos(theta) * sin(theta);

            numSamples++;
        }
    }
    oFragColor = vec4(PI * irradiance / float(numSamples), 1.0);
}
为了在场景边缘正确反映光照信息,Light Probe 在预计算时必须引入探针的实际空间位置 $\mathbf{P}_{\text{probe}}$ 以及包围盒 Bounds,并基于此矫正采样方向向量。其中,包围盒用于限制 Light Probe 的感知范围,并使其可以根据局部空间碰撞点,重新计算采样方向。
layout(location = 1) in vec3 iWorldPos; // 当前像素的世界坐标 P_object
uniform vec3 uProbeWorldPos;  // 探针的世界坐标 P_probe
uniform vec3 uBoxMin;         // 探针局部包围盒的 Min
uniform vec3 uBoxMax;         // 探针局部包围盒的 Max

// 计算视差矫正后的采样向量
// 输入:worldPos - 当前像素的世界坐标 P_object
//       rayDir - 从当前像素指向探针的射线方向向量
//       probePos - 探针的世界坐标 P_probe
//       boxMin - 探针局部包围盒的 Min
//       boxMax - 探针局部包围盒的 Max
// 输出:矫正后的采样向量
vec3 GetBoxProjectedDir(vec3 worldPos, vec3 rayDir, vec3 probePos, vec3 boxMin, vec3 boxMax) {
    // 1. 计算射线与 AABB 包围盒 6 个面的交点距离 t
    vec3 nrdir = normalize(rayDir);
    vec3 rbmax = (boxMax - worldPos) / nrdir;
    vec3 rbmin = (boxMin - worldPos) / nrdir;
    vec3 rbpt  = max(rbmax, rbmin);

    // 2. 取最小的正向交点距离
    float pVector = min(min(rbpt.x, rbpt.y), rbpt.z);

    // 3. 计算求交点坐标,并得出从探针位置指向该交点的矫正向量
    vec3 intersectionPoint = worldPos + nrdir * pVector;
    return intersectionPoint - probePos;
}
此外,相比普通的 IBL 技术,Unity 的 Light Probe Group 技术还引入了球谐函数系数的插值,以实现在场景边缘的光照信息正确反映。具体而言,其差值实现流程如下
- 几何构建:在运行时,Unity 会根据所有探针的世界坐标,使用 Delaunay 剖分算法 在 3D 空间构建一个四面体网格(Tetrahedral Mesh)。
- 位置定位与重心插值:当动态物体或像素在场景边缘移动时,引擎首先定位其所在的四面体,计算出当前世界坐标 $\mathbf{P}_{\text{object}}$ 在该四面体 4 个顶点处的重心坐标权重(Barycentric Weights) $w_0, w_1, w_2, w_3$。
- 动态 SH 系数重构:用重心权重对 4 个顶点的 SH 系数进行线性插值,得到该特定空间位置 $\mathbf{P}{\text{object}}$ 专属的插值 SH 系数:$$\text{SH}{\text{interpolated}} = \sum_{i=0}^{3} w_i \cdot \text{SH}_i$$
- 法线求交:最终在 Shader 中利用插值后的 $\text{SH}_{\text{interpolated}}$ 结合表面法线重建出绝对符合当前空间位置的间接漫反射光照。
5、除了传统基于预计算的 Light Probe 与 Reflection Probe 外,新一代游戏引擎还提供了诸如 Adaptive Probe Volume 等基于 Dynamic Diffuse Global Illumination 思想的动态探针,能够真正反映实时光照。请问相比传统探针,它们有何改进和提升。
动态漫反射全局光照(Dynamic Diffuse Global Illumination) 图形引擎实战:DDGI动态漫反射全局光照
SSGI
RTXGI
1、RTX 是什么?使用它实现 GI 的常见流程是什么?
RTX 是 NVIDIA 推出的基于硬件加速的光线追踪平台技术栈,核心依赖 GPU 内部的 RT Core(专门用于 BVH 树遍历与 Ray-Triangle 碰撞求交的硬件单元)以及 Tensor Core(用于 AI 降噪/DLSS)。
要在代码中使用 GPU 硬件 RT Core 加速光线追踪,开发者主要通过以下两个层级进行开发:
- 底层标准 API 扩展(Native API Extensions)—— 无厂商绑定,跨平台/跨显卡。
- 这是最底层、最通用的方式。无论是 NVIDIA (RTX)、AMD (RDNA 2/3/4) 还是 Intel (Arc),只要支持硬件光追,均通过标准图形 API 暴露的扩展接口来调度硬件求交逻辑。比如,Vulkan 中 用于创建 BVH 等加速结构的VK_KHR_acceleration_structure。
- 顶层高级 SDK(NVIDIA RTX Technology SDKs)—— 开箱即用的工程库。
- 如果开发者不想从零开始用 DXR/Vulkan 写一套复杂的间接光照采样、数据结构管理与降噪算法,可以直接调用 NVIDIA 在 DXR/Vulkan 之上进一步封装的高级 SDK 工具包:RTXGI、RTXDI、NRD等。
VXGI
OpenGL实现Voxel Global Illumination(VXGI) 计算机图形学:使用体素锥体跟踪实现全局渲染
1、一句话介绍一下 VXGI,说明它是如何实现的。
VXGI 是一种将场景几何与光照实时离散化为 3D 体素网格(使用 3D Mipmap 存储并加速),并在此基础上利用锥体追踪(Cone Tracing)快速步进采样以近似光线追踪的纯软件全局光照算法。
SDFGI
Shadow Mapping
Post-Processing
1、色调映射的工作原理?使用LUT进行色调映射和使用数学公式进行色调映射的区别?
色调映射能够将高动态范围(HDR,超出 $[0, 1]$ 的物理光照数值)的图片或帧压缩并映射到显示器能够呈现的低动态范围(LDR,通常为 $[0, 1]$)。其核心作用包括:
- 高光压制:避免高亮区域过度曝光(Clipping/爆白)。
- 暗部保留:保持暗部颜色的层次与对比度。
- 色彩修正:模拟人眼或胶片对强光的非线性响应(如高光处的自然褪色与对比度过渡)。
| 维度 | 数学公式(Closed-form Formula) | 3D LUT 查找(Look-Up Table) |
|---|---|---|
| 实现方式 | Shader 中直接运行曲线数学公式(如 ACES、Reinhard) | Shader 采样一张预先烘焙好的 3D 纹理并做插值 |
| 精度与质量 | 绝对连续,无阶梯感或颜色断层(Banding) | 受限于分辨率(如 $32^3 $ ),可能引入微小插值误差或断层 |
| 性能表现 | 随着公式复杂度上升(如多项式拟合),ALU 计算开销增加 | 性能恒定,仅消耗一次 3D 纹理采样的显存带宽 |
| 工程协同 | 难以在运行时由美术自由调整复杂曲线 | 美术极其友好,支持将 Tone Mapping 与调色(Color Grading)一次性合并烘焙进 LUT |
2、调色的工作原理是什么?它和色调映射的区别和联系是?
调色是对图像色彩进行风格化塑造的艺术与技术手段。它不负责解决物理光照的显示范围问题,而是负责建立画面氛围与情绪。换句话说,它是实现某种艺术风格的手段。
在现代游戏引擎中,为了节省性能,通常把 Tone Mapping 和 Color Grading 合并烘焙进同一张 3D LUT 中,在 Shader 里一次采样完成。
3、ACES相比Reinhard的优缺点。
Anti-Aliasing
抗锯齿技术可以从原理上分为两个大类:空域抗锯齿和时域抗锯齿。空域抗锯齿的代表是FXAA和SMAA,时域抗锯齿的代表就是TAA。
锯齿从表现上可以分为两类:几何锯齿(Geometric Aliasing)和着色锯齿(Shading Aliasing),如图所示:
- 几何锯齿,主要由于光栅化时的采样不足导致,体现在几何边缘的锯齿现象;
- 着色锯齿,主要由于渲染(例如光照计算)的采样不足导致,体现在画面中的部分像素点的闪烁或者噪点。
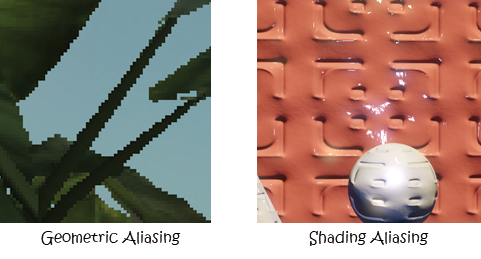
空域抗锯齿技术,是通过超采样几何边缘达到模糊边缘的效果,从理论上解释就是通过低通滤波抑制几何边缘的高频信息,它只能缓解几何锯齿,对着色锯齿无效。帧间抗锯齿技术,是通过加权混合相邻多帧达到抗锯齿效果,从理论上解释就是通过多次采样平均,来降低估计量的误差。毕竟,根据大数定律:假设各帧采样点的着色误差是独立同分布的,其方差为 $\sigma^2$。当我们将 $N$ 帧的时域采样点进行独立累加平均时,样本均值的方差为:$$\text{Var}(\bar{X}_N) = \frac{\sigma^2}{N}$$
MSAA
TAA
Other
V-SYNC & Double Buffering
1、双缓冲技术是什么?V-SYNC又解决了什么问题?
显示器并非一次性显示整张图像,而是从左到右、从上到下逐行扫描像素。若仅使用单缓冲区,GPU 更新帧数据时显示器可能正处于扫描中途,导致屏幕上下半部分分别显示不同帧的内容,即画面撕裂(Screen Tearing)。
双缓冲通过两块独立显存区域解决此问题:
- GL_FRONT(前缓冲区):只读,供显示器扫描输出
- GL_BACK(后缓冲区):只写,供 GPU 渲染
GL_FRONT和GL_BACK仅是 OpenGL 暴露给开发者的逻辑接口,实际底层实现可能是双缓冲、三缓冲甚至更多缓冲区的策略。例如三缓冲在双缓冲基础上增加一块 Back Buffer,允许 GPU 在 V-Sync 等待期间继续渲染下一帧,避免 GPU 闲置,但会额外增加一帧延迟和显存占用。
GPU 在 GL_BACK 完成一帧渲染后,通过交换指令(如 glfwSwapBuffers)快速切换两缓冲区指针,确保显示器始终读取完整帧。
双缓冲虽解决了读写冲突,但若 GPU 帧率远超显示器刷新率,仍可能在扫描途中交换缓冲区导致撕裂。V-Sync(垂直同步)强制 GPU 等待显示器完成整屏扫描并发出 V-Blank(垂直空白) 硬件信号后,才允许交换缓冲区指针,从而彻底消除撕裂。代价是引入输入延迟,且帧率低于刷新率时会触发整数倍降帧导致卡顿。
2、各厂商的技术对比?
| 技术 | 驱动 / 研发方 | 核心机制 | 优点 | 缺点 / 局限性 |
|---|---|---|---|---|
| V-Sync | 无特定厂商,行业通用标准 | 强制 GPU 等待显示器 V-Blank 信号后交换缓冲区,帧率锁定为显示器固定刷新率的整数倍 | 无需额外硬件,所有显卡和显示器通用;彻底消除画面撕裂 | 输入延迟高,低帧率时触发整数倍降帧导致明显卡顿 |
| G-Sync | NVIDIA | 显示器内置 NVIDIA 专有硬件模块,动态调整刷新率实时匹配 GPU 帧率 | 消除撕裂且输入延迟低;原生支持全范围低帧率补偿(LFC),同步范围可低至 0Hz;支持 ULMB 超低动态模糊 | 需 NVIDIA 显卡 + 内置 G-Sync 模块的显示器,硬件成本高导致显示器价格显著更贵;仅适配 NVIDIA 显卡 |
| FreeSync | AMD | 基于 VESA Adaptive-Sync 开放标准,通过 DisplayPort / HDMI 接口实现显示器刷新率动态匹配 GPU 帧率 | 无需专有硬件模块,显示器价格更经济;消除撕裂且输入延迟低;兼容性广,覆盖 AMD 及部分经认证的 NVIDIA 显卡 | 基础版无 LFC 支持,低帧率下可能失效;Premium 及以上等级才强制支持 LFC 和 HDR;不同显示器 VRR 范围差异较大 |